从番剧原片到角色干声:一次语音素材整理记录
2026.10.05 · 记录了一次提取番剧中角色干声,用于角色语音模型训练的鼓捣经历
最近在为训练角色的 voice model 准备语音素材,先把从番剧原片里提取干声的流程记下来。
番剧里的对白很丰富,同一个角色会用不同的语气说话,也会有停顿、叹气和情绪变化。但这些声音通常和配乐、环境音、动作音效混在一起,偶尔还会碰上几个人同时开口。想把它们整理成能用于训练的素材,光把视频转成音频还不够。
我目前用到的流程是:先拆出音轨和字幕,用人声分离工具处理音频,再根据清理过的字幕切句,最后逐条试听、按角色分类。文中沿用“干声”这个称呼,指尽量去掉配乐和杂声后的角色语音;处理结果仍可能残留混响或分离造成的失真,离录音棚里的原始配音还有距离。
先把音轨和字幕取出来
原片的准备过程就不展开了,这里从一份已经下载好的 MKV 文件开始。
我用 MKVToolNix 查看文件的轨道组成,确认需要的音轨和字幕轨道。一个文件里可能装着不同语言的音轨、不同版本的字幕,提取之前先看清楚,后面就不用拿着错误的素材重跑一遍。
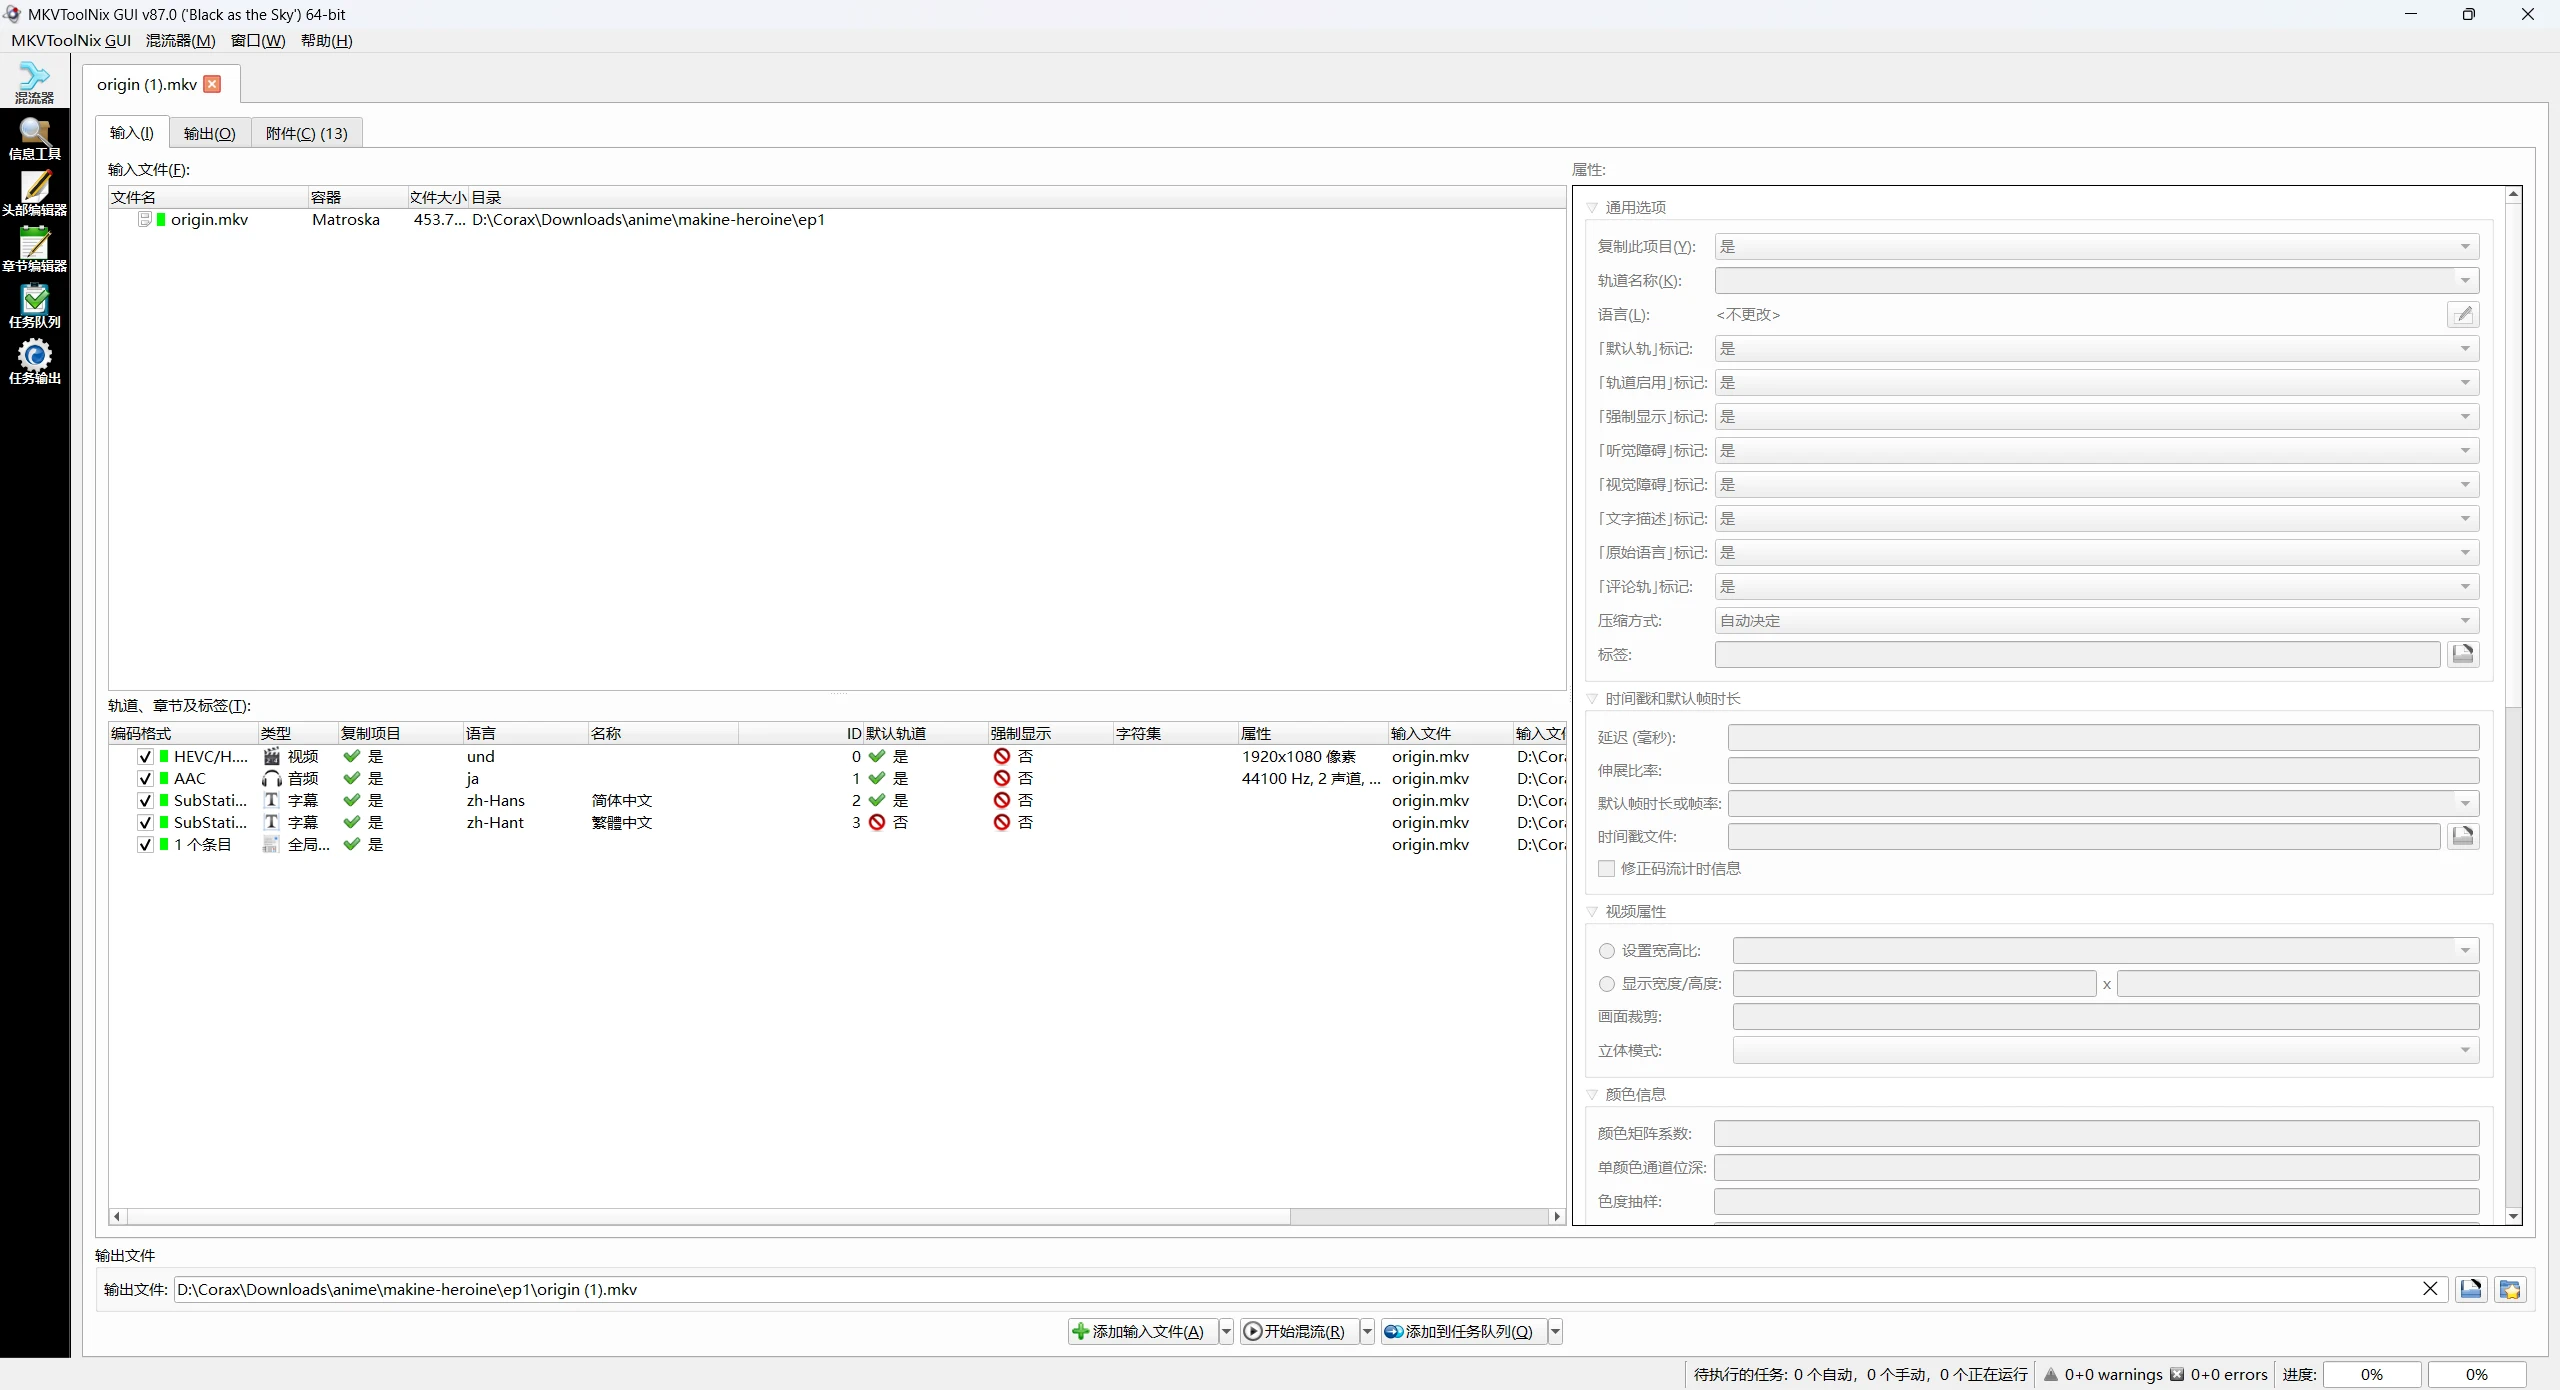
轨道信息也可以用命令查看:
mkvmerge --identify ".\origin.mkv"随后使用同套工具里的 mkvextract 提取。下面只是一个命令示例:假设识别结果中,1 对应需要的 AAC 音轨,2 对应 ASS 字幕,就可以写成:
mkvextract ".\origin.mkv" tracks "1:audio.aac" "2:words.ass"其中,origin.mkv 是源文件,tracks 表示提取轨道,后面的参数按“轨道 ID:输出文件名”填写。实际操作时,ID 和文件格式都要按自己的识别结果修改,不能直接照搬示例。当前版本的参数顺序可以查阅 mkvextract 官方文档。
这一步只是把轨道从容器里拿出来,并不会顺便完成音频转码。比如,给 AAC 音轨的输出文件取一个 .wav 后缀,并不能把它变成 WAV。如果后续工具需要另一种格式,应当另外转换。
建议保留原始音轨和字幕的副本。后续要清理字幕、调整时间轴、尝试人声分离参数,有一份未改动的源文件,回退和对照都会方便一些。
用 UVR 处理配乐和杂声
接下来用到的是 Ultimate Vocal Remover,下文简称 UVR。它负责音源分离,这一步的目标是尽量压低背景音乐,让对白更容易被单独取用。
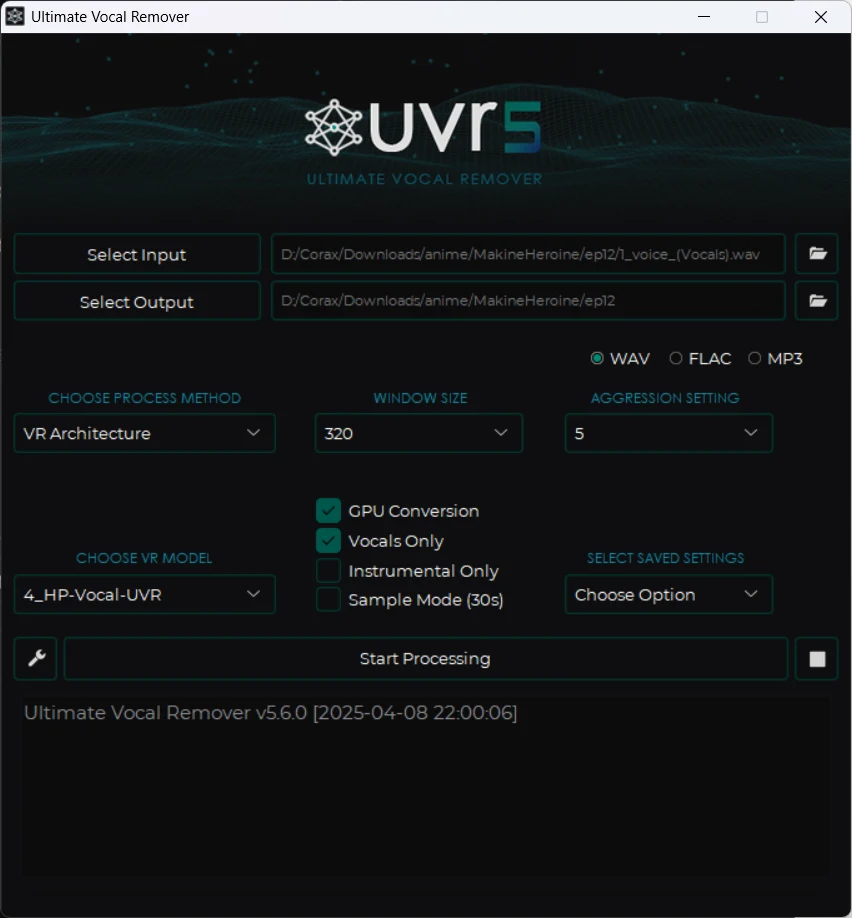
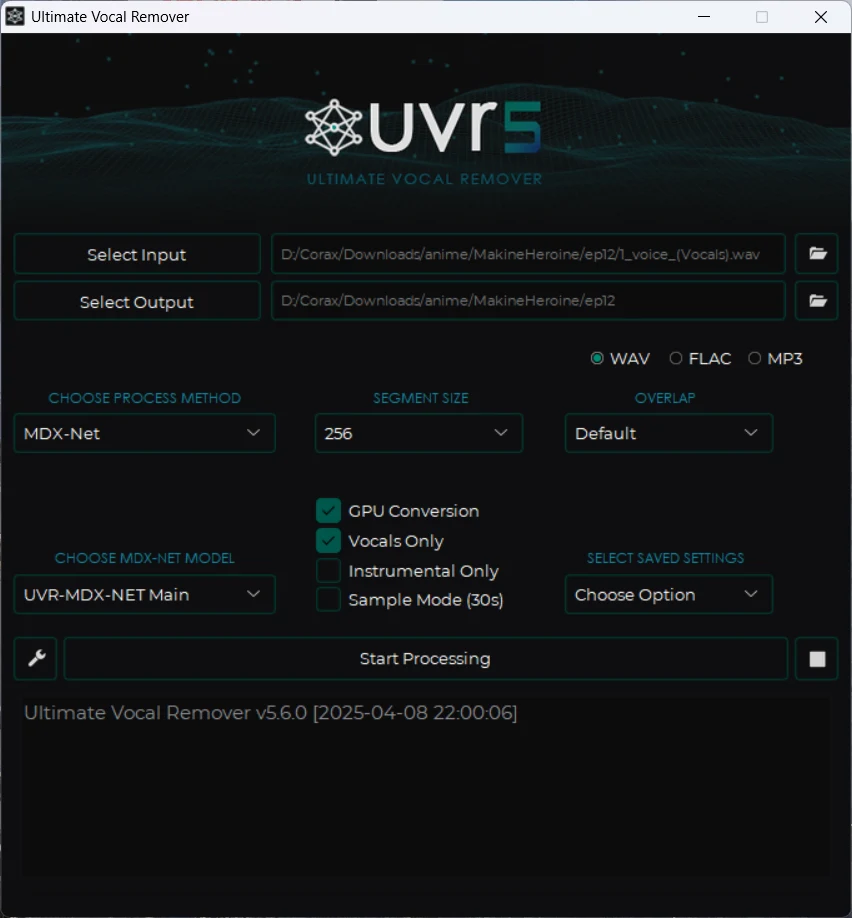
这次用了两套配置,对音频做两次处理,参数分别如下:
| 项目 | 配置一 | 配置二 |
|---|---|---|
| Process Method | MDX-Net | VR Architecture |
| 模型 | UVR-MDX-NET Main | 4_HP-Vocal-UVR |
| 主要参数 | Segment Size:256;Overlap:Default | Window Size:320;Aggression Setting:5 |
| 输出选项 | Vocals Only | Vocals Only |
| 输出格式 | WAV | WAV |
此外还勾选了 GPU Conversion。能否使用这一选项,要看自己的运行环境。上面列出的是这次使用的参数,具体效果仍需要结合自己的素材试听判断。
两套配置也不意味着任何片段都值得连续处理两遍。准备增加一轮处理时,可以先挑几段有代表性的对白试听:有安静场景的普通对话,也有背景音乐较重的片段。对照时除了听配乐还剩多少,还要留意说话声有没有忽强忽弱、尾音断裂,或出现明显的金属感。如果人声本身已经受损,就需要回到上一版结果重新判断。
每轮输出最好分别保留。这样遇到不理想的片段时,可以直接比较不同版本,不必凭印象判断“好像又干净了一点”。中间文件继续使用 WAV,也能避免反复导出成有损格式。
另外,Vocals Only 只表示保留分离出的人声部分。它不会自动知道我想要哪个角色,也不能据此认为重叠说话已经被拆开。片段里如果原本有两个人同时说话,后面仍需要单独检查。
清理字幕,让它先成为一份切句参考
人声处理完之后,我用 Subtitle Edit 整理字幕,保留与对白对应的条目。
直接拿整份字幕切音频,容易把歌词、制作人员信息、画面里的文字说明也一起切进去。字幕中出现了文字,并不代表那个时间点一定有人说话。因此,这一步需要同时看字幕内容和它对应的声音。
这份素材里的对白样式主要是 Dial_Language 和 Top_Language,分别用于底部和顶部的相应语言字幕,可以先借助它们缩小筛选范围。不过,这只是当前字幕文件采用的命名方式。ASS 的样式名可以自行定义,换一份字幕未必还叫这些名字,样式也不能直接证明说话人是谁。关于样式的含义,可以参考 Aegisub 的说明。
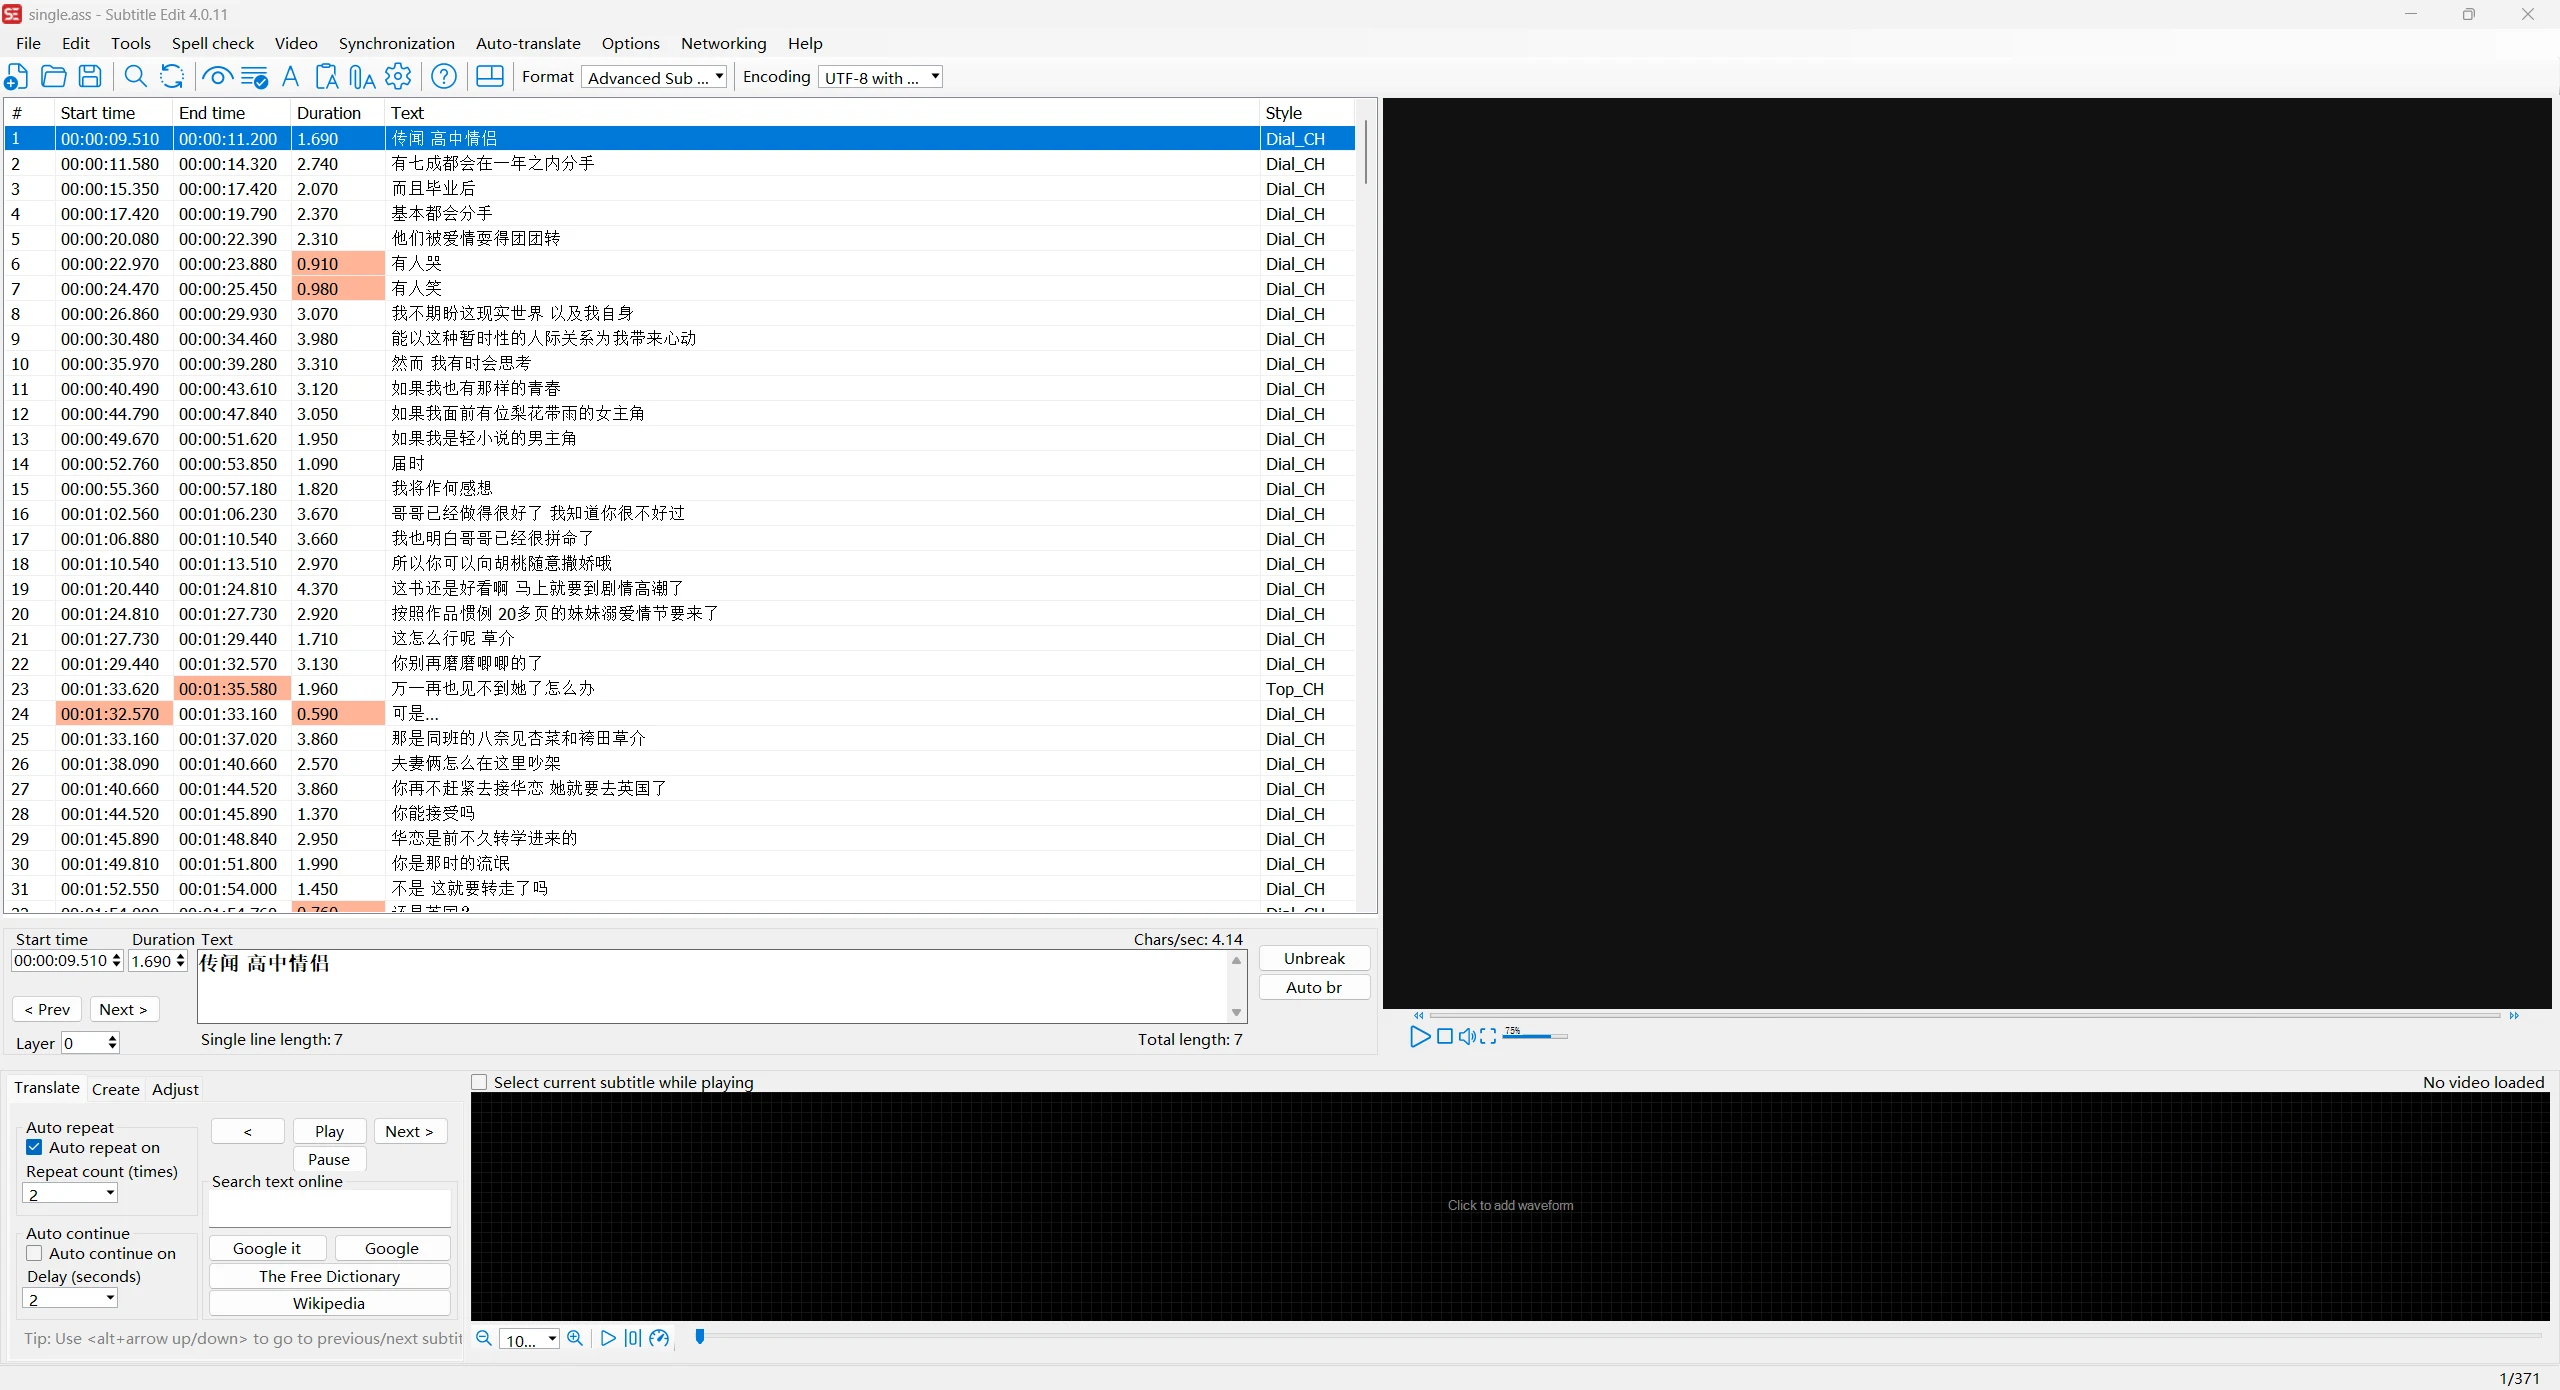
清理时还要留意双语字幕。同一句话如果以两种语言分别保存为两条记录,按条目切割就可能得到重复片段;如果两种语言本来就在同一条记录里,则不需要因为它有两行文字而重复处理。
字幕在这里主要提供时间参考。它什么时候出现、什么时候消失,未必刚好对应发音的起止位置:有的句尾还没说完,字幕已经切到下一条;有的一条字幕里连着两个人的对话。这些都需要在试听时继续修正。
如果后续选用的训练方案需要文本标注,也要把“用字幕定位”与“用字幕作转写”分开考虑。翻译字幕可以帮助理解剧情,但不能直接充当原语言语音的逐字转写。
按字幕切句,再检查每句话的边界
字幕整理好后,我用 QuickCut 的按字幕裁切功能,把长音频拆成一句一句的小片段。记录中的设置是每一句剪成一段,字幕时间偏移为 0.00。
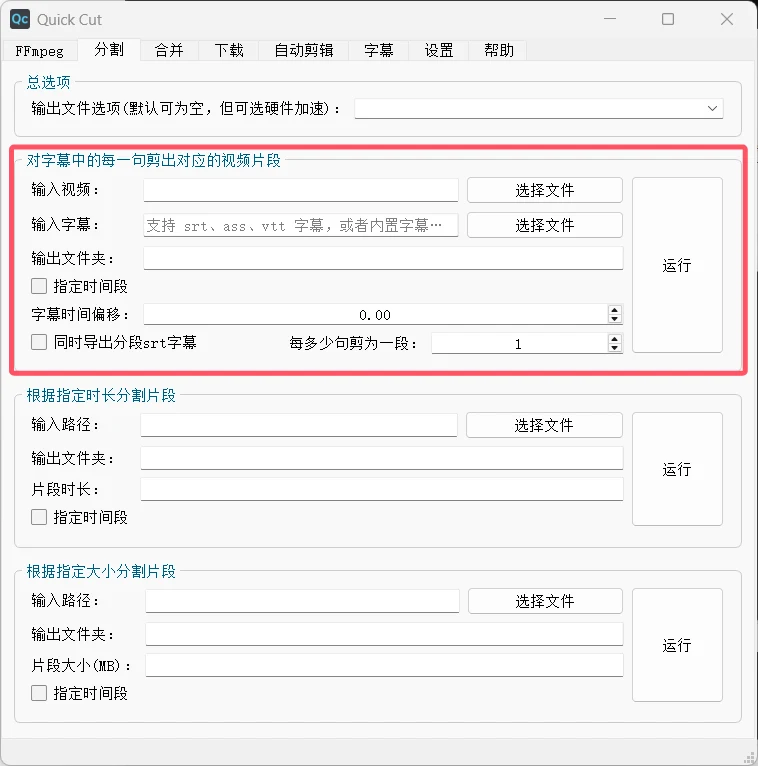
这里要选用前面处理后的人声音频。若误选回原始音轨,切出来的片段又会带上原来的配乐和音效,前面的分离也就没有用到这一步里。
偏移量为零只代表这次没有额外设置整体偏移。正式批量切割前,最好先检查开头、中间和靠后的几句,确认声音与字幕对得上。如果整集都固定提前或滞后一段时间,可以尝试统一调整;如果只有个别条目的边界不合适,就应该回到字幕里单独修改。
自动切完后,还需要逐条检查。重点听开头有没有少一个音、结尾是否被截断,以及前后有没有带入另一个人的声音。边界处可以保留少量自然停顿,具体留多少由实际发音决定,不必把每一句都裁到紧贴波形的位置。
文件名最好从这个阶段开始保留来源信息。例如,ep12_000123.wav 可以表示第十二集切出的第 123 个片段;另外保存它对应的原片时间,就能在发现问题时回去查看上下文。这只是一个命名示例,重点是以后仍然找得到它从哪里来。
逐条试听,把目标角色的声音分出来
最后一步用到 Audio Dataset Screener。它提供试听和人工筛选、分类的界面,适合处理前面切出来的大量短音频。
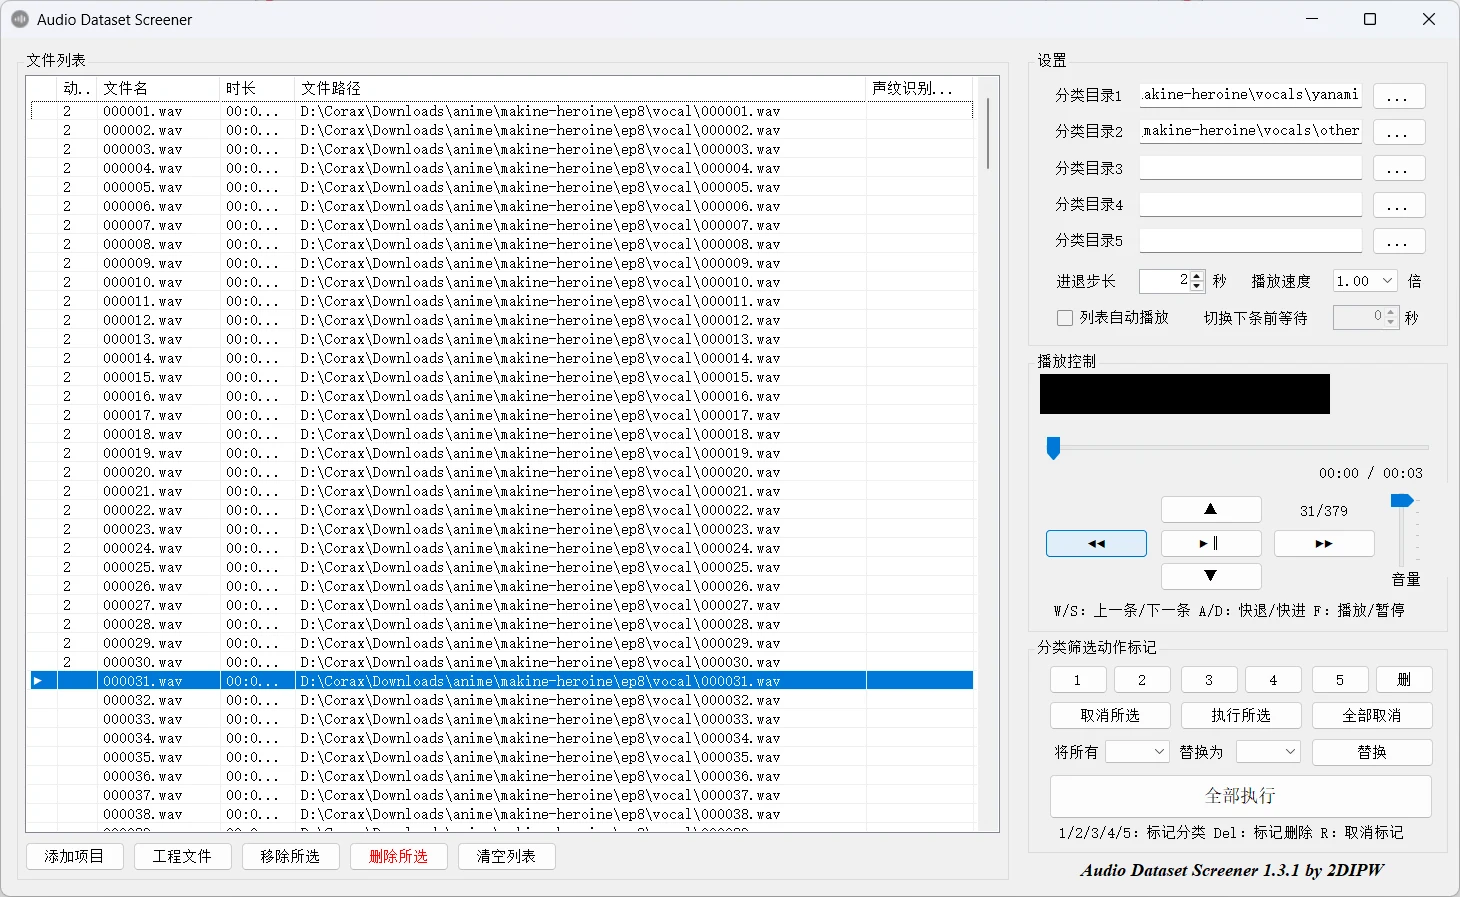
到了这里,每个文件虽然已经比较短,也经过了人声分离,但里面可能是目标角色、其他角色,或者几个人重叠的声音。需要听清是谁在说话,再判断这一段是否值得保留。拿不准时,回到原片看一下对应场景,比反复猜同一声短促的语气词更有用。
为了方便复查,可以先把片段分成几类:
- 目标角色,暂时保留:说话人明确,句子完整,没有明显的其他人声干扰。
- 目标角色,需要复查:身份确定,但有残留配乐、切句边界或音质方面的问题。
- 其他角色:单独归类,不混入当前角色的候选素材。
- 暂不采用:无法确认说话人、重叠严重,或处理后已经明显失真。
“需要复查”这一类很有必要。有些片段只需要重新裁一下边界,有些可以退回另一版分离结果。如果一开始就混进保留目录,后面还得重新找;直接删掉,又会失去再处理的机会。
语气和情绪也适合另外做标记。平静对白、喊叫、哭腔、笑声是否都要进入训练集,要看后续模型的用途。可以先把它们分开保存,等训练方案确定后再取舍,而不急着用同一套标准全部留下或全部排除。
整理到什么程度,再交给训练流程
整理这套流程后,我觉得值得多花些精力的地方,是判断每个片段为什么可以被留下。声音是否完整,说话人是否明确,有没有明显的分离失真,这些都需要在试听时确认。切出了多少个文件,还不能直接说明有多少可用素材。
另一个值得保留的习惯,是让处理过程能够回查。原始音轨、不同轮次的分离结果、清理过的字幕,以及片段对应的时间位置,最好都能找到。后续若想换一种处理方式,就可以从相应步骤继续,不用重新猜某个文件经历过什么。
走到这里,得到的是一批经过初步整理的角色语音候选素材。后续还需要按照实际选用的 voice model 项目,确认采样率、声道、片段长度、文本标注等要求,再完成最后一轮整理。